Alpy Data Portal
도입 문의

업계 최고 수준의 데이터 전처리, 운영, 관리 노하우를 모두 담았습니다


AI 데이터는 한 번이 아니라 지속적으로 구축, 검증, 관리, 운영되어야 합니다
복잡한 관리 과정과 도구를 한 번에
수집부터 적재까지, 하나의 데이터 파이프라인
데이터 수집부터 적재까지 하나의 파이프라인으로 연결합니다. 각 단계의 산출물이 다음 단계로 자동 연계되고 전체 실행 이력까지 통합 관리해 효율성을 높일 수 있습니다.


업무별 맞춤 데이터 파이프라인 설계
업무에 맞게 필요한 노드만 조합
기본 노드에 필요한 커스텀 노드를 자유롭게 조합해 업무 시나리오에 최적화된 데이터 파이프라인을 구성할 수 있습니다. 필요한 기능만 유연하게 구성해 다양한 데이터 처리 업무에 빠르게 대응할 수 있습니다.
*파싱(Alpy Knowledge Compiler), 청킹, 임베딩 도구 기본 제공
매번 처음부터 다시 재처리할 필요 없이
변경된 데이터만 빠르게 처리
게시물과 첨부파일을 각각 하나의 문서로 관리하고, 메타데이터를 비교해 변경된 데이터만 선별적으로 처리합니다. 불필요한 데이터의 반복 처리를 줄여 처리 시간과 시스템 리소스를 절감할 수 있습니다.


사용자에게 허용된 데이터만 안전하게
사용자별 문서 접근 권한 관리
원천 시스템의 부서 정보를 함께 수집하고 로그인 계정의 소속 부서와 대조해, 사용자에게 접근이 허용된 문서만 운영 화면에 노출합니다. 별도의 관리 없이 사용자별 데이터 접근을 일관되고 안전하게 통제할 수 있습니다.
어떤 데이터가 잘못됐을까
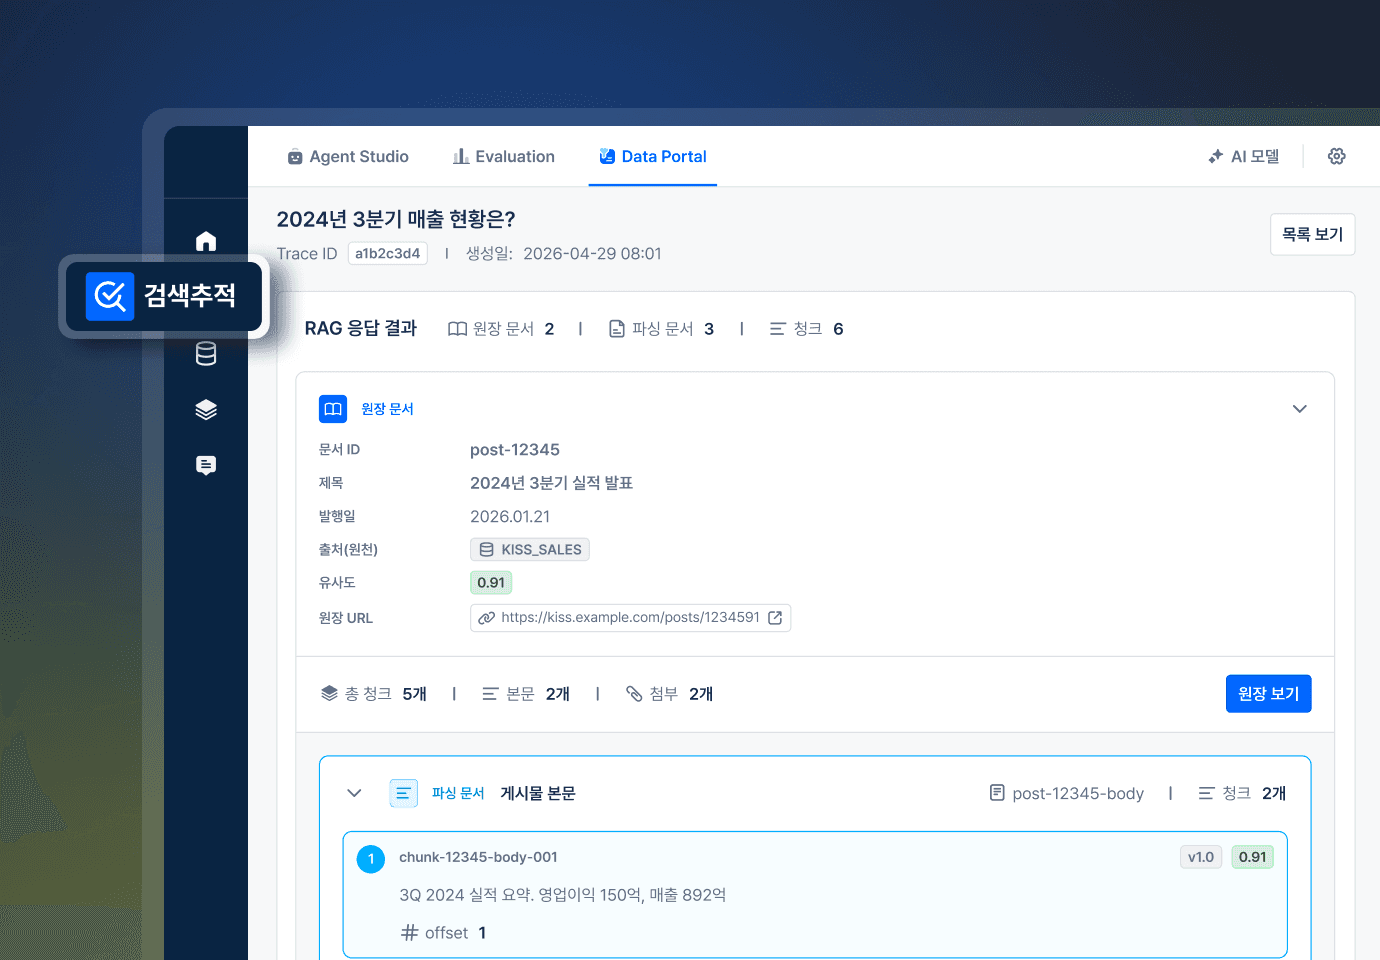
검색 결과의 출처까지 추적
검색 응답에 참조된 청크를 모두 확인하고, 각 청크가 어떤 문서의 어느 페이지에서 추출되었는지 역추적할 수 있습니다. AI가 어떤 데이터를 근거로 답변했는지 쉽게 확인할 수 있어 검색 결과의 신뢰성과 검증 가능성을 높입니다.